导语:
本文作者为解决一个JDK性能问题,从堆栈分析,到GC分析,再到Safepoint原因分析,最终定位到问题根因与所用的JDK版本有关 。并整理成文,与所有Java相关开发的同学分享此次经验 。01 问题来了
笔者近期在工作中遇到这样一个问题:某客户新上线了一个Elasticsearch应用,但运行一段时间后就变的特别慢,甚至查询超时 。重启后服务恢复,但每隔3~4小时后问题重现 。
针对这个问题,我身边的同事也帮忙做了简单分析,发现存在大量Merge的线程,应该怎么办呢?根据我之前定位问题的经验,一般通过Thread Dump日志分析,就能找到问题原因的正确方向,然后再分析该问题不断重复的原因 。按照这个思路,问题分析起来应该不算复杂 。But,后来剧情还是出现了波折 。
02 困惑的堆栈日志
因网络隔离原因,只能由客户配合获取Thread Dump日志 。并跟客户强调了获取Thread Dump日志的技巧,每个节点每隔几秒获取一次,输出到一个独立的文件中 。集群涉及到三个节点,我们暂且将这三个节点称之为39,158,211 。问题复现后,拿到了第一批Thread Dump文件:
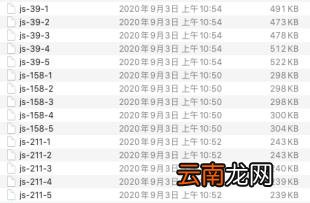
从文件的大小,可轻易看出39节点大概率是一个问题节点,它的Thread Dump日志明显大出许多:查询变慢或者卡死,通常表现为大量的Worker Thread忙碌,也就是说,活跃线程数量显著增多 。而在ES(Elasticsearch,以下简称为ES)的默认查询行为下,只要有一个节点出现问题,就会让整个查询受牵累 。
那么我们先对三个节点任选的1个Thread Dump文件的线程总体情况进行对比:
节点名称39158211线程总数366341282RUNNABLE264221162WAITING648892TIME_WAITING283228BLOCKED1000再按线程池进行分类统计:
节点名称39158211Lucene Merge Thread7700http_server_worker646464search494949transport_client_boss286430bulk323232generic1564transport_server_worker275529refresh10510management523warmer555flush555others495451可以发现:39节点上的Lucene Merge Thread明显偏多,而其它两个节点没有任何Merge的线程 。
再对39节点的Thread Dump文件进行深入分析,发现的异常点总结如下:
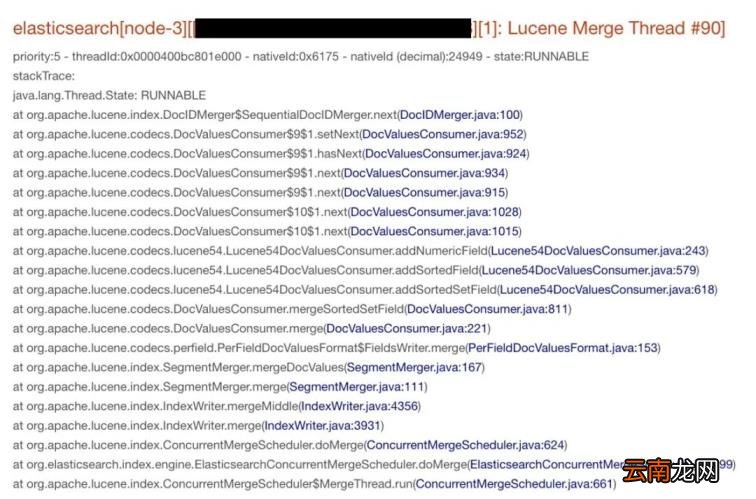
1. Lucene Merge Thread达到77个,其中一个线程的调用栈如下所示:
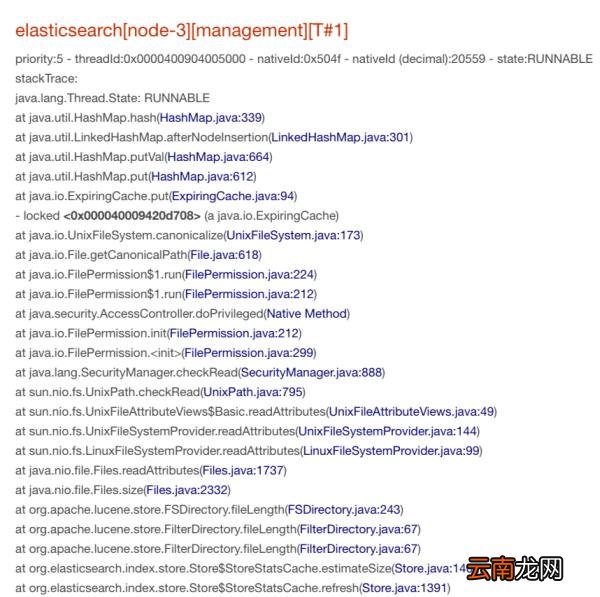
2. 有8个线程在竞争锁定ExpiringCache:
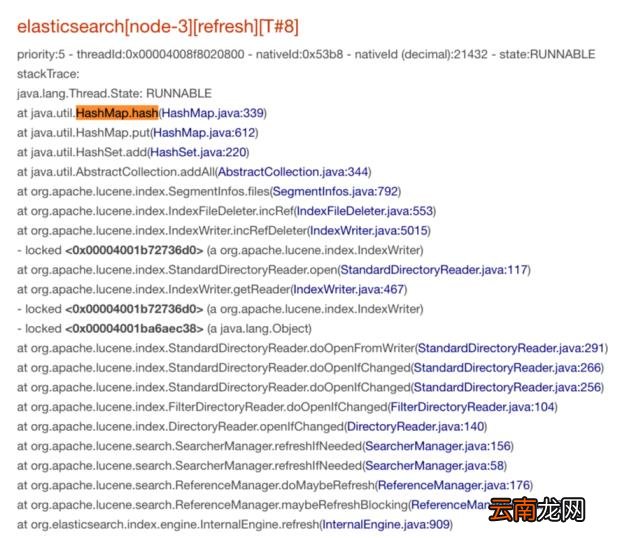
3. 有8个线程都在做HashMap#hash计算:
现象1中提到了有77个同时在做Merge的线程,但无法确定这些Merge任务是同时被触发的,还是因为系统处理过慢逐步堆积成这样的状态 。无论如何这像是一条重要线索 。再考虑到这是一个新上线的应用,关于环境信息与使用姿势的调研同样重要:
- 集群共有3个节点,目前共有500+个Indices 。每个节点上写活跃的分片数在70个左右 。
- 按租户创建Index,每个租户每天创建3个Indices 。上线初期,写入吞吐量较低 。每个索引在每分钟Flush成的Segment在KB~数MB之间 。
关于第2点现象,我认真阅读了java.io.UnixFileSystem的源码:
- UnixFileSystem中需要对一个新文件的路径按照操作系统标准进行标准化 。
- 标准化的结果存放在ExpiringCache对象中 。
这加剧了我关于使用姿势的怀疑:”细雨绵绵”式的写入,被动触发Flush,如果周期相同,意味着同时Flush,多个Shard同时Merge的概率变大 。
于是,我开始在测试环境中模拟这种使用方式,创建类似的分片数量,控制写入频率 。计划让测试程序至少运行一天的时间,观察是否可以复现此问题 。在程序运行的同时,我继续调查Thread Dump日志 。
第3点现象中,仅仅是做一次hash计算,却表现出特别慢的样子 。如果将这三点现象综合起来,可以发现所有的调用点都在做CPU计算 。按理说,CPU应该特别的忙碌 。
等问题在现场复现的时候,客户协助获取了CPU使用率与负载信息,结果显示CPU资源非常闲 。在这之前,同事也调研过IO资源,也是非常闲的 。这排除了系统资源方面的影响 。此时也发现,每一次复现的节点是随机的,与机器无关 。
一天过去后,在本地测试环境中,问题没能复现出来 。尽管使用姿势不优雅,但却不像是问题的症结所在 。
03 诡异的STW中断
通过jstack命令获取Thread Dump日志时,需要让JVM进程进入Safepoint,相当于整个进程先被挂起 。获取到的Thread Dump日志,也恰恰是进程挂起时每个线程的瞬间状态 。
所有忙碌的线程都刚好在做CPU计算,但CPU并不忙碌 。这提示需要进一步调查GC日志 。
现场应用并未开启GC日志 。考虑到问题当前尚未复现,通过jstat工具来查看GC次数与GC统计时间的意义不太大 。让现场人员在jvm.options中手动添加了如下参数来开启GC日志:
 8:-XX:+PrintGCDetails
8:-XX:+PrintGCDateStamps
8:-XX:+PrintTenuringDistribution
8:-XX:+PrintGCApplicationStoppedTime
8:-Xloggc:logs/gc.log
8:-XX:+UseGCLogFileRotation
8:-XX:NumberOfGCLogFiles=32
8:-XX:GCLogFileSize=32m添加PrintGCApplicationStoppedTime是为了将每一次JVM进程发生的STW(Stop-The-World)中断记录在GC日志中 。通常,此类STW中断都是因GC引起,也可能与偏向锁有关 。
刚刚重启,现场人员把GC日志tail的结果发了过来,这是为了确认配置已生效 。诡异的是,刚刚重启的进程居然在不停的打印STW日志:
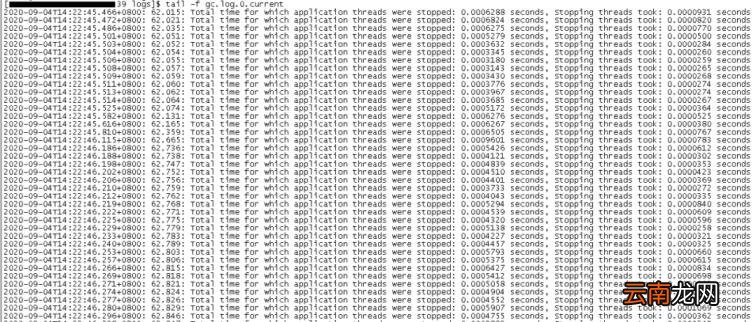
关于STW日志(”…Total time for which application threads were stopped…”),这里有必要简单解释一下:
JVM有时需要执行一些全局操作,典型如GC、偏向锁回收,此时需要暂停所有正在运行的Thread,这需要依赖于JVM的Safepoint机制,Safepoint就好比一条大马路上设置的红灯 。JVM每一次进入STW(Stop-The-World)阶段,都会打印这样的一行日志:
2020-09-10T13:59:43.210+0800: 73032.559: Total time for which application threads were stopped: 0.0002853 seconds, Stopping threads took: 0.0000217 seconds在这行日志中,提示了STW阶段持续的时间为0.0002853秒,而叫停所有的线程(Stopping threads)花费了0.0000217秒,前者包含了后者 。通常,Stopping threads的时间占比极小,如果过长的话可能与代码实现细节有关,这里不过多展开 。回到问题,一开始就打印大量的STW日志,容易想到与偏向锁回收有关 。直到问题再次复现时,拿到了3个节点的完整的GC日志,发现无论是YGC还是FGC,触发的频次都很低,这排除了GC方面的影响 。
出现的大量STW日志,使我意识到该现象极不合理 。有同学提出怀疑,每一次中断时间很短啊?写了一个简单的工具,对每一分钟的STW中断频次、中断总时间做了统计:
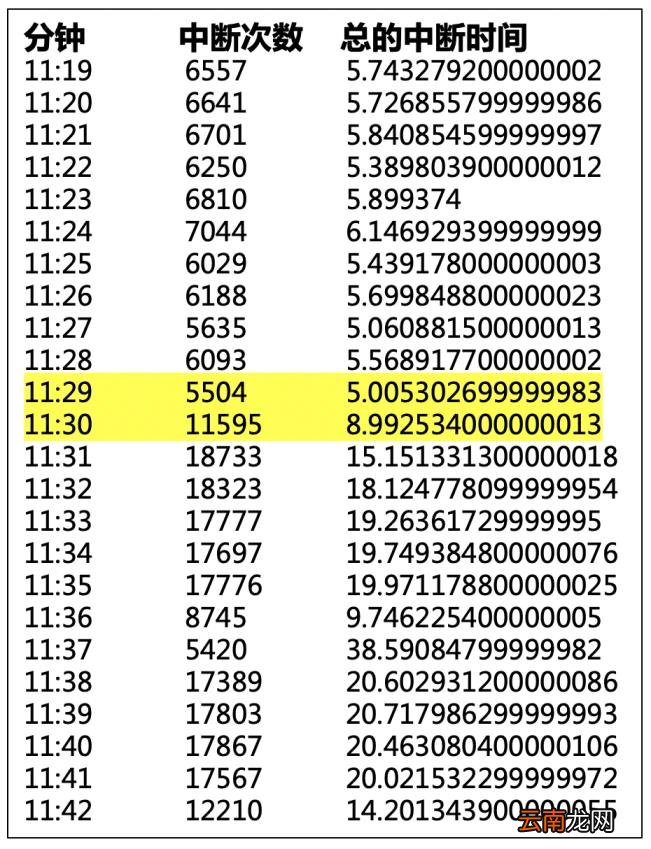
统计结果显示:
- 正常每分钟都有5秒左右的中断 。
- 在11:29~11:30之间,中断频次陡增,这恰恰是问题现象开始出现的时间段 。每分钟的中断总时间甚至高达20~30秒 。
04 关于Safepoint的调查
Safepoint有多种类型,为了确认Safepoint的具体类型,继续让现场同学协助,在jvm.options中添加如下参数,打开JVM日志:
-XX:+PrintSafepointStatistics
-XX:PrintSafepointStatisticsCount=10
-XX:+UnlockDiagnosticVMOptions
-XX:-DisplayVMOutput
-XX:+LogVMOutput
-XX:LogFile=<vm_log_path>
等待问题再次复现的过程中,我基于ES运行日志中统计了每一分钟的读写请求频次: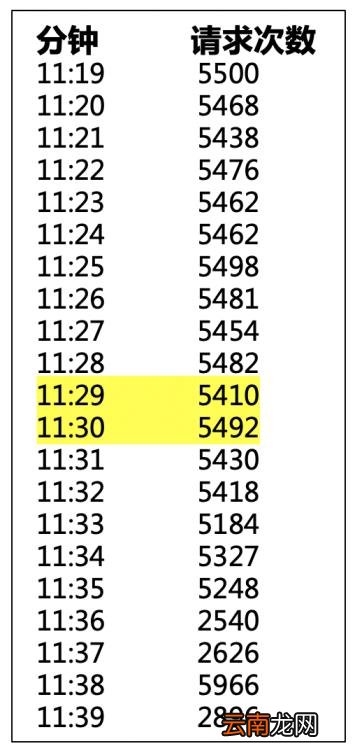
读写请求次数是相对平稳的,这排除了用户请求陡增方面的原因 。
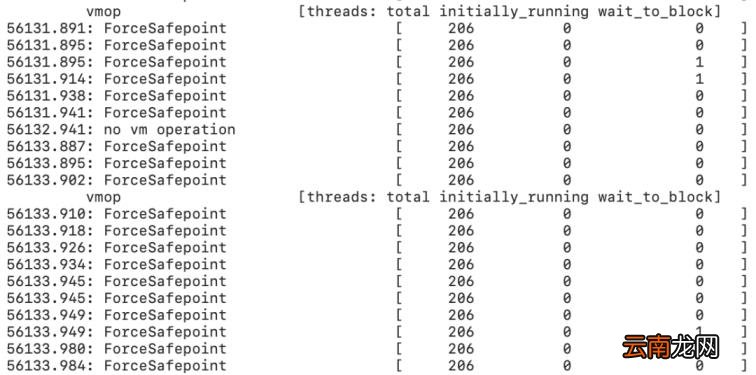
拿到JVM日志时,看到大量的Safepoint类型为ForceSafepoint:
而偏向锁回收相关的Safepoint却应该是长这样的:
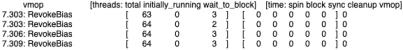
这让我疑惑了 。开始在网上搜索ForceSafepoint的触发原因,结果,一无所获 。
查看hotspot的源码,发现至少有5种相关场景:
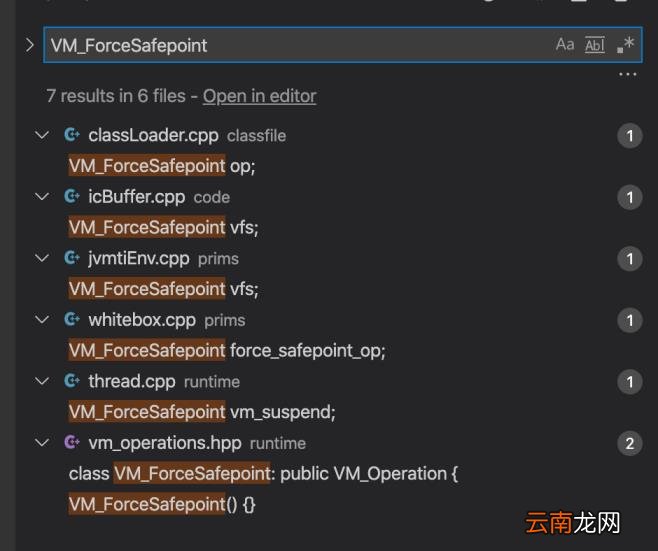
可见,ForceSafepoint是一个“杂烩”,就像统计图中的“Others”一项 。从这里开始,我将JDK加入到了“重点嫌疑人”清单中 。
继续分析JVM日志 。在每一条Safepoint日志中,同时记录了当时的线程总数(threads: total一列):

回顾一下,出现问题时,三个节点的线程总数有明显出入,问题发生后,线程总数是增多的,尤其是Lucene Merge Threads 。
“多个Lucene Merge任务”与“陡增的ForceSafepoint/STW中断”,哪个是“因”哪个是“果”?
依据JVM日志中统计了每一分钟的ForceSafepoint次数,以及线程总数的变化 。将两条曲线叠加在一起,得到下图:
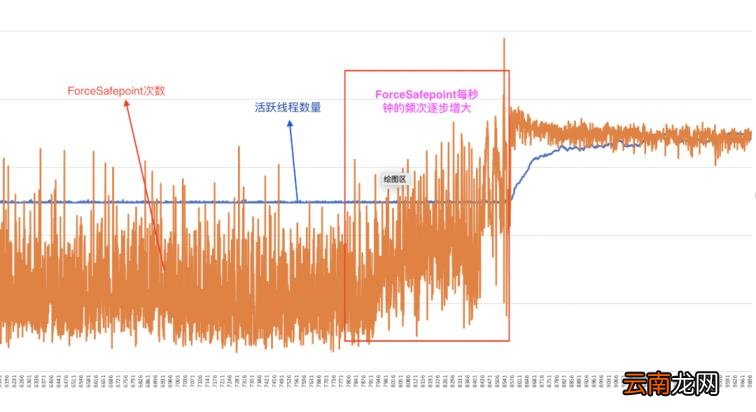
从图中来看,似乎是ForceSafepoint逐步增多在先,后面的线程才逐步增多 。也就是说,STW中断变多在先,然后多个Merge任务线程才开始逐步积累,就好比,一条目录上突然增设了多个红绿灯,然后这条目录逐步变得拥堵 。
此时,开始请教Kona JDK团队的同学,我把GC日志以及thread dump日志分享给了他,并把我目前为止的发现都告诉了他,最大的怀疑点就是这些不正常的ForceSafepoints,我需要了解ForceSafepoints的原因 。
过了一段时间后,他回复我:这个是arm版本的jdk 。因缺乏arm编译机应急柜,暂时没法给我提供一个debug版本的arm jdk 。
突然明白,我犯了”先入为主”的错误,尽管一开始就意识到需要对环境进行调查 。
难怪在本地X86环境中始终无法复现 。难怪网上搜索ForceSafepoint时一无所获 。
接下来和客户电话会议沟通时,获知:
- 类似的业务,在另外一套X86环境中,没有发现此类问题 。
- 在这套arm环境中,还有另外一个Elasticsearch集群,请求量更低,但没有发现此类问题 。
- 环境中使用的arm jdk是从网上下载的,背后支持的厂商未知 。
至此,问题原因清晰的指向了arm环境与JDK版本 。
后来,微服务平台TSF团队的臧琳同学介入,他提供了一个添加了debug信息的Kona JDK版本,尽管这个版本比正常版本慢了许多,更换以后,我们发现问题重现的周期明显变长 。
拿到最新的JVM日志后,臧琳同学分析这些ForceSafepoint都与Inline Cache Buffer有关 。当然,这可能是arm环境下所有JDK版本的共性问题,也可能仅仅是之前下载的JDK版本存在问题 。
接下来,我们将环境中的JDK版本替换成正式Release的Kona JDK 。再后来,问题始终没有复现 。也就是说,替换成Kona JDK后,问题解决了 。
我统计了一下使用KonaJ DK后的STW中断次数与中断时间,发现有数量级的提升:
- 原JDK版本:每分钟STW中断5000次~18000次,每分钟中断总数据可能达到10秒~30秒 。
- Kona JDK: 每分钟STW中断在个位数,每分钟中断总时间在100~200ms之间 。
05 总结回顾
我们再来梳理一下整个问题的分析思路:
1. 通过堆栈分析,发现大量的线程都在做CPU计算,但 CPU资源较闲 。关于大量Merge Threads的现象带有一定的迷惑性,但它是问题的“果”而非“因” 。
2. 通过GC日志分析,发现GC频次与GC时间都很低,但GC日志中存在大量的STW相关日志,需要确认关联的Safepoint类型 。
3. 通过VM/Safepoint日志分析,确认了Safepoint的类型为ForceSafepoint 。通过不同环境与不同集群的现象对比,开始怀疑JDK版本存在问题 。
4. 更换Kona JDK后,ForceSafepoints频次由每分钟5000多次降低到个位数,问题解决 。
通过本次问题的分析,得到一个教训:问题分析初期应该认真调研集群环境 。当然,最大的教训是:千万不要乱下载JDK啊!
- 甜品店的优势与劣势swot分析,甜品店的优势与劣势swot分析?
- 老龄化服务创业项目,老龄化服务创业项目经验分享?
- 产品代理销售方案,产品代理销售方案策略分析?
- cps推广是什么意思,cps推广名词含义解释?
- 毕业论文初稿要写到什么程度,毕业论文初稿要写到什么程度及出现的问题?
- 淘宝客推广,淘宝客推广定义攻略?
- 10元店进货渠道,10元店进货渠道如何选品?
- 免费入驻的卖货平台,免费入驻的卖货平台有哪些?
- 创业团队主要五个职务,抖音运营创业团队主要五个职务?
- 淘宝网客服,淘宝网客服的话术技巧?